
Claude Codeを業務外で使い始めてから、公開情報の分析やブログの制作に継続して活用してきました。現在はOpenAIのCodexも併用しています。非エンジニアの大学職員でも、目的を伝え、結果を確認しながら、情報収集やファイルの加工を進められます。
タイトルにある「今はまだ早い」は、使い始めた当初の評価です。公開情報を扱う個人の作業での活用と、大学の内部情報を使う業務への導入は分けて考える必要があります。継続利用後の評価を2026年10月に追記し、Codexの説明や情報管理、大学の導入事例も見直しました。
Claude Codeとは何か
Claude CodeはAI企業Anthropicが2025年にリリースしたAIエージェントツールです。
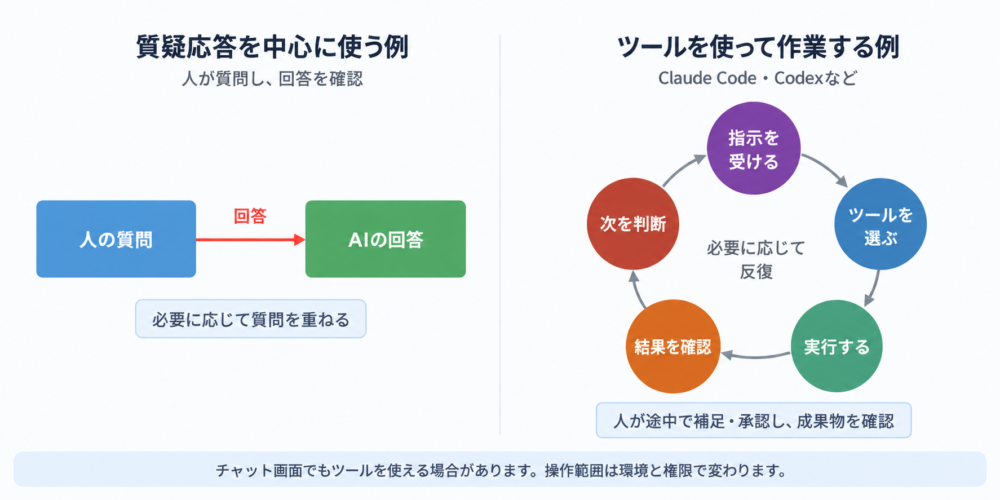
Claude Codeの特徴は、対話しながら作業対象のファイルを読み、編集し、必要なコマンドを実行して、その結果を確認しながら次の処理へ進めることです。作業の途中でも、人が指示を補足したり、結果を確認したりできます。実行できる操作は、利用環境や許可した権限によって変わります(Anthropic「Claude Code Overview」)。
チャット画面から使うAIにも、検索やファイル分析、外部ツールを使った作業ができるものがあります。たとえば「ChatGPT Work」も、ファイルや利用を許可したツールを使って複数の手順を進めます。比較する際は、どのファイルやツールにアクセスできるか、成果物を直接編集できるか、複数の手順をどこまで続けて実行できるかに注目すると、用途の違いがわかりやすくなります。
筆者は、公開されている複数大学の決算書を読み取り、比較表を作る作業を試しました。こうした使い方でも、抽出した数値や比較条件の確認は欠かせません。具体的な体験は後半で紹介します。
プログラミングの知識は必ずしも必要ありません。ただし、何を指示すれば何が起きるかを把握している必要はあります。そこが「誰でも使えるか」という問いへの正直な回答を難しくしている部分です。
OpenAIのCodexもある
OpenAIのCodexも、ファイルを読み、編集し、コマンドを実行しながら作業を進めるAIエージェントです。GitHubとの連携は、すべての利用方法で必須というわけではありません。デスクトップアプリでのローカル作業や、コマンド入力画面で使う「Codex CLI」では、手元の作業フォルダを対象にファイルの確認・編集やコマンドの実行ができます。
筆者も現在はClaude CodeとCodexを併用し、業務外でブログ記事の作成や確認に使っています。非エンジニアにとっても、資料の整理、文章やデータの加工、成果物の確認といった用途で活用できます。
大学職員の業務でできること
非エンジニア向けの活用として現実的なものを挙げます。
文書・データ処理
– 複数のPDFから特定の数値を抽出して比較表を作る
– 規程・要綱の新旧対照表を自動生成する
– 会議録の文字起こしデータから要点を整理する
情報収集・分析
– 他大学の公開情報(決算書・事業報告書)を横断的に収集・比較する
– 文科省通知・法令改正の要点をまとめる
コンテンツ作成
– 学内向け通知文の草案作成
– 広報用資料のたたき台作成
これらの作業で扱える情報は、公開の有無だけでなく、個人情報や機密情報を含むか、利用するサービスの契約条件や学内規程に合うかによって変わります。
現状のリスク:機密情報・個人情報の観点
ここが本題です。大学職員がClaude Codeを業務で使う際の最大の障壁は、技術的な習熟度ではなく情報管理の問題です。
入力情報の取り扱い
Anthropicの個人向けプラン(Free・Pro・Max)では、モデル改善への利用設定を有効にした場合、Claude Codeでのやり取りもモデルの学習に利用されます。法人向けのTeam・EnterpriseやAPIでは、顧客が明示的に提供した場合などを除き、学習には利用されません(Anthropic「Data usage」、2026年10月10日確認)。
ただし、学習に使われないことと、外部へ送信・保存されないことは別です。契約や設定ごとに、送信される情報、保存条件、アクセスできる範囲を確認する必要があります。
個人情報を含む入力について、個人情報保護委員会は、特定した利用目的を達成するために必要な範囲内かを確認し、個人データが応答以外の目的で扱われる場合の同意や学習利用などに注意するよう求めています(「生成AIサービスの利用に関する注意喚起等(PDF)」p.2)。公開されている情報でも、この確認が不要になるわけではありません。未公表の財務・予算情報や入試情報などは、個人情報に当たるかに加え、機密情報としての学内規程や契約上の条件も確認します。
設定に関するセキュリティリスク
過去には、プロジェクトを信頼するか確認する前に処理が走り、コード実行やAPIキー流出につながるClaude Codeの脆弱性が報告されました。記事で取り上げた2件は、CVE-2025-59536がv1.0.111、CVE-2026-21852がv2.0.65で修正済みです。2026年2月25日のCheck Pointの調査報告も、公表前に修正されたことを明記しています。
これらは信頼確認の実装に関わる製品の不具合でした。利用者側でも、古い版を使い続けず、出所のわからないプロジェクトや設定を安易に信頼しないことが大切です。
ガイドラインとAIガバナンスの現在地
総務省・経済産業省のAI事業者ガイドライン第1.2版(PDF)(2026年3月31日)は、AIの開発・提供・利用に関わる事業者が取り組むべき事項を整理しています。ここで重要な概念がAIガバナンスです。
AIガバナンスとは、AIを使うための技術的な設定だけでなく、「誰が何の業務にどのAIを使えるか」「問題が起きたときの責任の所在」「利用状況のモニタリング体制」といった組織的な意思決定・管理の枠組みを指します。大学での導入でも、ツールの選定と合わせて、こうした運用体制を整えることが大切だと考えます。
2026年2月20日の国立情報学研究所(NII)のシンポジウムでは、伊藤忠テクノソリューションズ(CTC)が、企業の生成AI利用ルールを大学へ応用する方法を紹介しています。発表資料(PDF)では、利用目的と情報区分に応じて許容条件を定める方法(p.11)と、大学への転用案(p.18)が示されています。組織として「何をどの条件で使えるか」を定める際の参考になります。
現時点での正直な評価
公開情報の収集・分析や、内部情報を含まない文章の草案作成では、すでに活用できる場面があります。使い始める際には、作業対象を絞り、どのファイルを読み、どの操作を実行するかを確認しながら進めることが大切です。
一方、学生対応記録、人事・給与データ、未公表の予算情報、入試情報などを扱う場合は、所属機関の規程と利用条件の確認が必要です。生成した文章を外部に公開しなくても、入力した情報がAIサービスへ送信されることはあるため、出力先だけでは判断できません。
ローカルのファイルを扱うことも、AIの処理がすべて端末内で完結することを意味しません。Claude Codeの公式資料は、ローカル実行でもモデルとの通信でプロンプトや出力を送受信すると説明しています。OpenAIの「ChatGPT Work local security」でも、処理に必要なファイルの抜粋やツールの実行結果などがサービスへ送られる場合があると説明されています。
| 扱う情報の例 | 入力前に確認すること |
|---|---|
| 個人情報・機密情報を含まない公開資料 公表済みの決算書、通知、事業報告書など | 所属機関が認めたサービス・用途であることを確認し、必要な資料に対象を絞ります。 |
| 個人情報を含む資料 学生の成績、教職員の人事情報、個人を特定できる会議録など | 利用目的、契約・学習利用の条件、学内規程、必要な同意・承認を確認します。公開済みの情報も確認の対象です。 |
| 機密情報を含む資料 未公表の財務・予算情報、入試情報など | 学内の情報区分と、外部送信・保存に関する契約条件、必要な承認を確認します。 |

それでも「将来は必須ツール」だと思う理由
大学職員の業務の本質は「情報処理」です。複数の書類から必要な情報を取り出し、比較し、判断に必要な形に整理する作業の繰り返しです。
筆者は、データの読み取り、表の作成、通知文の草案、過去事例の検索といった作業をAIに任せられる場面が増えていくと考えています。その分、人には判断の根拠を確かめることや関係者との合意形成がより求められるでしょう。AIに任せた作業でも、速さや正確さは対象によって異なり、結果の確認は必要です。
大学の問い合わせ対応では、以前からチャットボットの導入事例があります。ギブリーは2019年6月、法政大学による「SYNALIO」の導入事例を公開しています。SYNALIOは当時の名称で、2023年4月にDECAへブランド統合されました。これは問い合わせ対応の事例であり、ファイル編集やコマンド実行を伴うClaude Codeのようなエージェントの導入効果を示すものではありません。
日経リサーチが公表した2025年の学長アンケートでは、回答した532大学のうち316校(59%)が生成AIを学部教育で活用していました。教育面の活用状況を示す数値であり、大学事務でのAIエージェント導入率ではありません。業務への導入では、それぞれの用途に応じて効果と利用条件を確かめる必要があります。
利用条件を確認して試す
組織の業務で試す際には、次の順に確認すると、入力する情報だけでなく、ツールに許可する操作や結果の扱いも整理できます。
| 確認する順番 | 判断と対応 |
|---|---|
| サービス・契約・用途 | 所属機関が認めた組み合わせかを確認します。不明な場合は、業務情報を入力する前に担当部署へ確認します。 |
| 入力する情報 | 表1の情報区分に照らして、必要な確認・承認を済ませます。確認できない情報は入力せず、作業対象から外します。 |
| 実行する操作 | 読み取り・編集するファイルや、実行を許可する操作を必要な範囲に絞ります。外部送信や上書きの内容も確認します。 |
| 結果の確認 | 数値・出典・内容を人が確認してから採用します。誤りや想定外の動作があった場合の報告先も決めておきます。 |
試す対象としては、公表済みの決算書の比較、文科省通知の要点整理、内部情報を含まない文章の草案などが考えられます。所属機関では情報区分と利用ルールを明文化し、対象を絞った試行で効果や確認負担を把握したうえで、利用範囲を広げるのがよいと考えます。
実際にやってみた
筆者は2026年5月、業務外の個人の試行として、慶應・明治・立教の2024年度決算書を比較分析しました。約30分で作業を進めた経緯は、別記事「大学職員がClaude Codeで3大学の決算書を分析した話」にまとめています。この試行では比較表の作成まで進められましたが、抽出した数値や比較条件の確認は必要です。1件の体験から、どの資料でも同じ速さや精度で分析できるとまではいえません。
また、基幹業務システムのデータ周りについて生成AIに質問しながら理解を深めた経験は、note記事「「業者に任せるしかない」領域に、AIで踏み込んだ話」で紹介しています。
その後使い続けて変わった評価(2026年10月追記)
Claude CodeとCodexをブログの制作や公開情報の分析に使い続け、個人の作業ではすでに実用的な道具になっていると感じています。
ただし、作業を任せられることと、結果が正しいことは別です。財務データなら単位や対象年度、数値の出典を確認し、記事なら事実関係や説明の妥当性を点検する必要があります。読み取りや加工をAIに任せても、何を比較し、どの結果を採用し、どう説明するかは人が判断します。
現在の評価は、公開情報を扱う個人の作業では経験を積める段階にあり、組織の業務では利用条件と管理体制を整えて導入を進める段階にある、というものです。大学職員が考えるべきことも、「どの業務を、どの条件で任せるか」へ移っていくと考えています。
まとめ
Claude CodeやCodexは、公開情報の分析や成果物の作成を支える道具として、すでに活用できる場面があります。非エンジニアでも、目的と確認すべき点を整理することで、作業の一部を任せられます。
大学の業務で使うには、入力する情報の区分、利用するサービスの契約条件、操作権限、確認責任を明確にする必要があります。使える範囲から経験を積み、その経験を組織のルールや確認手順へつなげることが、現実的な導入の進め方だと考えています。
AIが経理・事務の仕事をどう変えるかは、『AI大格差』(宮本弘暁・著)の書評でも掘り下げています。合わせてご覧ください。

参考資料(情報管理・導入事例):
Anthropic:Claude Code Data usage(2026年10月10日確認)
個人情報保護委員会:生成AIサービスの利用に関する注意喚起等(PDF)(2023年6月2日、p.2)
Anthropic:CVE-2025-59536の修正告知(修正版v1.0.111)
Anthropic:CVE-2026-21852の修正告知(修正版v2.0.65)
Check Point:Claude Codeのプロジェクトファイルに関する脆弱性の調査報告(2026年2月25日)
総務省・経済産業省:AI事業者ガイドライン第1.2版(PDF)(2026年3月31日)
CTC:企業における生成AI利活用ガイドライン―大学でも転用できる「最小セット」の設計(PDF)(NIIシンポジウム発表、2026年2月20日、p.11・18)
日経リサーチ:2025年の学長アンケートの公表(2025年12月9日)
ギブリー:法政大学のSYNALIO導入事例の公表(2019年6月18日)
ギブリー:SYNALIOのDECAへのブランド統合(2023年4月4日)
製品仕様の参考資料(2026年10月8日確認):
Anthropic:Claude Code Overview
OpenAI:Codex environments
OpenAI:Codex CLI
OpenAI:Get started with ChatGPT Work
OpenAI:ChatGPT Work local security


