AIエージェントは、質問に答えるだけでなく、ブラウザの操作やファイルの編集といった作業を人の代わりに実行するAIです。Claude CodeやCodexが有名です。下調べや文書の下書き、Excelの数値加工やグラフの作成など、大学の事務にも使えそうな場面があります。
一方で、2026年9月から11月にかけて、エージェントの利用にかかわるニュースが続けて公表されました。外部サービスによる遮断、認証情報の平文保存、委託先からの会話記録の流出です。
この記事では、大学事務での活用場面と、組織として使う際の注意点を整理します。
筆者の勤務先で利用はしていませんが、公開資料と一般的な実務知見の範囲で書いています。出典は末尾の参照資料にまとめています。
先に全体をまとめると、次の表のとおりです。
| 観点 | 要点 |
|---|---|
| できること | 複数の資料を調べてまとめる、文書の下書きを作る、データを加工する、Web上の定型的な操作を補助する |
| 外部サービス | サービス側の規約でエージェントのアクセスが禁じられ、遮断されることがある |
| 認証情報 | 許可した操作の記録にパスワードが残ることがある。秘匿情報は別の場所で管理する |
| 入力した情報 | AIサービスの委託先で起きた事故により、会話記録が流出することがある |
| 組織のルール | 権限を必要な範囲に絞り、記録を残し、取り消せない操作の前に人が確認する |
表の「組織のルール」の行は、後述する国のガイドラインの記載を踏まえた筆者の整理です。
AIエージェントとは:チャット型AIとの違い
総務省・経済産業省の「AI事業者ガイドライン(第1.2版)」(2026年3月31日、PDF)は、AIエージェントを、特定の目標を達成するために環境を感知して自律的に行動するAIシステムと定義しています(本編 p.11)。
開発用のエージェントと常時稼働型のアシスタント
エージェントと呼ばれる製品は、大きく2つの型に分けられます。分け方は筆者の整理です。
1つは、Claude CodeやCodexのような開発用のエージェントです。Claude Codeの公式ドキュメントは、コードを読み、ファイルを編集し、コマンドを実行するコーディング用のツールと説明しています。利用者が指定したフォルダの中で、指示された作業を進めるのが基本の動き方です。
もう1つは、OpenAIの「dots」やMetaの「Muse」のような、常時稼働型のアシスタントです。OpenAIの「dots のご紹介」(2026年9月29日)によると、dotは専用のクラウドコンピューターとブラウザを持ち、4,000以上のアプリに接続できます。利用者とやり取りしていない間も、接続済みのアプリを読み取り専用で参照し、手伝えることを探します。Museは2026年9月8日に公開された個人向けのエージェントで、メール、予定表、支払、買い物などのサービスにつながり、専用のブラウザを備えた仮想マシン上で動くとMetaは説明しています(後述する『GeekWire』の記事による)。
2つの型は、別の技術というより、任せ方の違いです。『TechCrunch』の記事「How OpenAI turned its coding tools into dots, an always-on personal assistant」(2026年10月26日)で、OpenAIの担当者は、dotsの機能の多くはCodexでも実現できるが、より多くの手間と細かな指示が必要になると述べています。
| 項目 | チャット型AI | 開発用エージェント(Claude Code、Codex) | 常時稼働型アシスタント(dots、Muse) |
|---|---|---|---|
| 主な動作 | 質問に文章で答える | 指示された作業を、ファイルの編集とコマンドの実行で進める | 目標を預かり、指示がない間も調べものや提案を行う |
| 動く場所 | 提供元のサービス上 | 利用者が指定したフォルダや作業環境 | 提供元が用意する専用のクラウド環境とブラウザ |
| つながる先 | 入力された文章やファイル | ファイル、コマンド、開発用のツール | メール、予定表、支払など多数の外部サービス |
| 認証情報 | 入力や添付ファイルに含めなければ扱わない | 利用者の環境にあるものを使う | 提供元の保管領域に預けて使わせる |
| 主なリスク | 誤った回答、入力した情報の扱い | 意図しない変更や削除、設定や記録に残る認証情報 | 意図しない送信や購入、接続先の規約、預ける情報の範囲 |
表は各社の説明と後述の事例をもとにした筆者の整理です。開発用エージェントにもクラウド上で動く形態があり、dotは許可すれば利用者のPCにも接続できるなど、製品ごとに例外があります。
後で取り上げる3つの事例は、型との対応で読むとわかりやすくなります。Amazonによる遮断は常時稼働型、認証情報の平文保存は開発用エージェント、会話記録の流出は、Notionの中で動くAIエージェントで起きたもので、チャットを含むAI機能全般にかかわる話です。
チャット型AIの回答に誤りがあっても、人が読んで気づけば作業には反映されません。エージェントは操作まで実行するため、誤りがそのまま結果になります。同ガイドラインの別添は、AIエージェントが自律的な動作の中で、人の意図しない商品の注文やファイルの削除などを行う可能性があると記しています(別添 p.19、PDF)。
大学事務での活用場面
筆者の知る限り、日本の大学で、AIエージェントを事務の業務に使っているところは今のところありません。一方で、製品の側は教育機関での利用も想定しています。OpenAIは、教育機関向けを含む法人プランで、管理者が有効にすればdotsのベータ版を使えるとしています。
そのためこの節は導入事例の紹介ではなく、エージェント製品が一般に備えている機能を、大学事務の業務に当てはめた筆者の整理です。特定の製品での動作を保証するものではありません。具体的な使い方の例は、次の表のとおりです。
| 場面 | エージェントに任せる作業の例 | 人が確かめること |
|---|---|---|
| 調査 | 他大学が公表している決算書を集め、自分の大学の数値と並べた比較表を作る | 数値を転記元のページと照合する |
| 資料の作成 | フォルダにある複数の資料を読み、要点をまとめた会議資料を作る | 要約の漏れや誤りがないか |
| メール | メールの受信をきっかけに、返信の下書きを作る | 内容と宛先。送信は人が行う |
| データの加工 | 基幹システムから出力したデータを、言葉で指示して集計・加工する | 件数や合計を元のデータと照合する |
| 割り当て | 教室配当などをルールに従って作り、共有用や掲示用の資料にも反映する | 重複や条件の漏れ、資料どうしの食い違い |
| Web操作 | ブラウザで使うシステムの操作を、Chromeの拡張機能で自動化する | サービス側が自動操作を認めているか |
調査の下調べ
公開情報を複数のサイトから集めて一覧にする作業は、エージェントに向いています。たとえば、他大学が公表している計算書類や事業報告書を集め、自分の大学の数値と並べた比較表を作らせる使い方です。省庁や関係団体の通知・公募要領の所在確認、制度改正の経緯の整理にも使えます。
制約は、出典の読み違いや、実在しない資料の引用が起こりうることです。決算書は大学ごとに科目の細かさや様式が違うため、比較表の数値は転記元のページと突き合わせて確かめます。結論に使う数値や条文は、人が原資料に当たって照合する前提で使うのがよさそうです。
文書の下書き
チャット型AIでは資料を1件ずつ貼り付ける必要がありますが、エージェントはフォルダを指定すれば、中の資料をまとめて読めます。複数の資料から要点を拾い、会議資料の形にまとめるところまでを任せられます。通知文や、規程改正の対照表のたたき台も同じ要領で作れます。
メールと連携できる製品では、メールの受信をきっかけに返信の下書きを作らせる使い方もできます。常時稼働型のアシスタントが得意とする場面です。任せるのは下書きまでで、送信は人が内容と宛先を確かめてから行います。
未公表の情報や個人情報を入力してよいかは、契約しているサービスの条件と学内の規程によります。
データの加工と割り当て
基幹システムから出力したデータを加工する作業も、エージェントに任せやすい場面です。「部署別に集計して前年度と比べる」のように言葉で指示すれば、関数やマクロを自分で書かなくても、エージェントが手順を組み立てて実行します。
教室配当のように、条件が決まっている割り当ての作業にも使えます。収容人数、設備、時間割といったルールを文章で渡すと、割り当ての案を作り、共有用の資料や掲示用の資料への反映まで続けて行います。
制約は、もっともらしいが誤った結果が出ることです。集計は件数や合計を元のデータと照合し、割り当ては重複や条件の漏れがないかを確かめます。個人情報を含むデータは、入力してよいサービスかどうかを先に確認します。
定型的なWeb手続きの補助
ブラウザで使うシステムであれば、Chromeの拡張機能として動くエージェントに、決まった手順の操作を任せられます。公開サイトからの定期的な資料の取得や、複数の画面にまたがる情報の照合にも使えます。
4つの場面のうち、制約がもっとも多いのはこの場面です。拡張機能は、利用者がログインしたブラウザをそのまま操作するため、その利用者の権限でできる操作はエージェントにもできてしまいます。サービス側がエージェントによる操作を認めているかの確認も必要です。
注意点:公表された事例から
外部サービスの規約と遮断:AmazonによるMuseの遮断
米国のIT系メディア『GeekWire』は2026年9月20日、米AmazonがMetaのAIエージェント「Muse」を遮断したと報じました(「Amazon blocks Meta’s Muse AI assistant in new standoff over agentic shopping」)。Museが利用者に代わってAmazon.comで買い物をすることを止めた、という内容です。
同記事によると、Amazonが挙げた理由は3点です。MetaからMuseがストアにアクセスするという事前の説明がなかったこと、エージェントがサイト上で身元を明示しないこと、利用者の認証情報を取得して保存しているように見えることです。Museで買い物をしようとした利用者には、許可されていないAIエージェントによるアクセスの継続は、利用者が同意した利用規約に違反する、という趣旨の警告が表示されました。
3点目の認証情報について、Metaは記事の時点でコメントしていません。一方、Metaは公式発表「Introducing Muse: The World’s First Personal AI Agent Built for Everyone」(2026年9月8日)で、利用者が預けた認証情報は安全な保管領域に置かれ、Museは中身を見ずにそれを使うと説明しています。Amazonが問題にしているのは認証情報が取得・保存されること、Metaが説明しているのはAIが中身を見られないことで、両社は別の点を述べています。
同記事は、AmazonがPerplexityのブラウザ「Comet」をめぐって同社を提訴し、GoogleやOpenAIの買い物用エージェントの遮断にも動いてきたと伝えています。
ここからは筆者の推定です。業務で使うクラウドサービスや外部の申請サイトにも、それぞれ利用規約があります。規約が自動化されたアクセスを制限していれば、遮断やアカウントの利用制限を受ける可能性があります。また、Amazonの警告が利用者に向けて表示されたことから、規約上の責任はエージェントの提供元だけでなく、アカウントを持つ利用者の側にも及びうると考えます。法人で契約しているアカウントであれば、影響は担当者個人にとどまりません。
認証情報の扱い:許可した操作が平文で残る
セキュリティ企業のApiiroは2026年11月5日、調査結果「Coding Agents Are Leaking Your Secrets to GitHub」を公表しました。対象は、プログラム開発用のエージェントであるClaude Codeです。
Claude Codeは、コマンドを実行する前に利用者の許可を求めます。このとき「以後確認しない(Yes, and don’t ask again)」を選ぶと、コマンドの文字列が許可ルールとして、プロジェクト内の .claude/settings.local.json に保存されます。コマンドにパスワードやAPIキーが含まれていれば、それも平文のまま保存されます。このファイルがプログラムと一緒に公開リポジトリ(プログラムなどを誰でも見られる形で置く保管場所)へ登録されると、認証情報が誰でも読める状態になります。
Apiiroによると、GitHubで公開されていた同ファイル104,185件のうち、1,122件(1.1%)に認証情報が含まれていました。過去の履歴や共有用の設定ファイルなども含めると、1,994のリポジトリで2,539件にのぼります。認証情報かどうかは、既知のキーの形式に合うか、公開されたホストと並んで書かれているかで同社が判定したもので、実際に使えるかどうかは試していないと説明しています。大学のリポジトリで、公開サーバーに管理者権限で接続するコマンドが恒久的に許可されていた例も挙げられています。数値はいずれも同社の調査によるものです。
同じページの追記によると、Anthropicの担当責任者は11月7日、防止策を検討していると回答しました。あわせて、このファイルは作成時にgit(ファイルの変更履歴を管理する仕組み)の管理対象から外す設定がされるため、公開されていたものは手作業で作成・登録されたものだという見方を示しています。
Apiiroが勧める対策は、コマンドに認証情報を直接書かずに変数として参照すること、個別のコマンド文字列ではなくパターンで許可すること、ファイルに載っていた認証情報を変更することです。
以下は筆者の意見です。開発用に限らず、エージェントが許可の設定、操作の記録、会話の履歴をファイルやサービス上に残す点は多くの製品に共通すると考えます。パスワードを含む文字列を渡せば、その記録にも残ると考えたほうが安全です。パスワードやAPIキーは、設定値をまとめて書く別ファイル(.env など)やパスワード管理ツールに分け、エージェントへの指示には変数名だけが出るようにします。そのファイル自体を共有フォルダや公開の場所に置かないこと、中身をエージェントに読み取らせないことも必要です。
委託先からの情報流出:Notion AIの会話記録
Notionは2026年11月9日、セキュリティ情報「Fireworks AI incident」を公表しました。AIの処理基盤を提供するFireworks AIで起きた事故により、Notionのワークスペースの1%未満が影響を受けたという内容です。
Notion AIには、ページやデータベースの作成・編集、検索などを利用者に代わって行う「Notion Agent」という機能があります(Notionのヘルプ「What is Notion AI? FAQs」)。ブラウザやPCを操作する製品とは毛色が違いますが、Notionの中で動くAIエージェントと考えるとわかりやすいと思います。
公表文によると、不正にアクセスされた可能性のあるデータに、Notion AIの会話記録が含まれていました。AIの利用状況を分析する「Insights」という機能のために、Fireworksで処理されていたものです。影響を受けたワークスペースの大半では、会話記録に書き手やワークスペースを示す情報は付いておらず、ツールの実行結果も含まれていなかったとされています。Notion自身のシステムへの侵入ではないとも説明しています。
Notionは11月3日の朝までにFireworksとの接続を切り、11月4日に同社上のデータを削除しました。影響を受けた利用者には、対象のデータは流出したものとして扱い、期間中にNotion AIへ貼り付けたパスワードやAPIキーを変更するよう勧めています。11月11日には、調査の過程で見つかったNotionのAPIキーを無効化したと追記しました。調査は継続中とされています。
以下は筆者の意見です。利用者が契約している相手はNotionでも、入力した内容はその先の事業者で処理されることがあります。組織としては、契約の前にサービスの委託先と入力データの保存条件を確認すること、AIとの会話に認証情報や個人情報を貼り付けないことが対策になると考えます。
組織のルール:AI事業者ガイドラインの「AI利用者」
「AI事業者ガイドライン(第1.2版)」は、事業活動でAIシステムやAIサービスを利用する事業者を「AI利用者」と呼び、第5部で重要事項を挙げています(本編 p.40〜41)。大学が業務でAIサービスを使う場合も、このAI利用者に当たると筆者は考えます。エージェントの利用に関係する項目は次のとおりです。
- AI提供者が定めた利用上の留意点を守り、想定された範囲内で利用する(U-2)
- 個人情報を不適切に入力しない(U-4)
- 機密情報等を不適切に入力しない。AI提供者によるセキュリティ上の留意点を守る(U-5)
- AI提供者が定めたサービス規約を守る(U-7)
第5部の冒頭には、人間の判断を介在させることで予期せぬ事故を防ぐことも可能になる、という記載もあります。また、開発者・提供者・利用者に共通する指針として、利用時の入出力などのログを合理的な範囲で記録・保存することが挙げられています(本編 p.20)。別添は、AIエージェントが外部のサービスと連携して動く過程で、攻撃によって挙動を不正に操作され、機密情報が漏えいする可能性にも触れています(別添 p.21)。
ガイドラインは、エージェントを使う組織向けの手順を一覧にしているわけではありません。上の記載をエージェントの利用に引き直すと、筆者は次の3点に整理できると考えます。
| 観点 | 線引き |
|---|---|
| 権限 | エージェントに渡すアカウントとフォルダを、その業務に必要な範囲に絞る |
| 記録 | いつ、誰が、何を指示し、何が実行されたかを後から追えるようにする |
| 最終確認 | 送信、申請、支払、削除など、取り消せない操作の前に人が確認する |
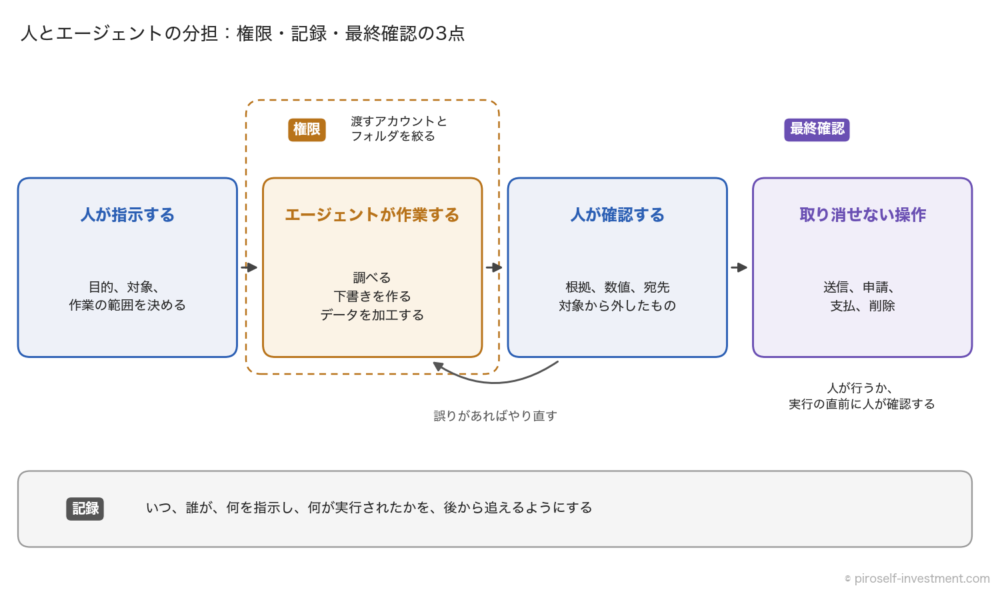
権限を必要最小限にするという考え方は、別添ではAI提供者向けのセキュリティ対策として書かれています(別添 p.146)。利用する側にも同じ考え方が当てはまるというのは、筆者の解釈です。
書籍でも、同じ方向の整理がされています。岡野原大輔『ヒトとAI』(岩波新書)は、エージェントの行動を現実の世界に安全につなぐ枠組みを「ハーネス」と呼び、目的、制約、評価基準、権限、停止条件を外から与えて、どこまでやってよいかを定めるものと説明しています。記録については、判断の履歴が残っていなければ、組織は自らの行為を説明することすらできないと述べています。権限と責任の委譲も、個人の裁量ではなく制度として設計し、どこまでをエージェントが判断してよいか、どの条件で人に戻すか、異常時にどう止めるかを、あらかじめ決めておく必要があるとしています。


 ポチップ
政府職員向けの基準:デジタル庁の「源内基準」
エージェントを使う側の遵守事項を具体的に定めた例として、デジタル庁の「源内基準」があります。正式な名称は「ガバメントAI 源内 ガバナンス・セキュリティ・セーフティに関する基準」(第1版、2026年10月、PDF)です。源内は、デジタル庁が開発・運用する政府職員向けの生成AI利用環境です。デジタル庁の公表ページによると、約18万人の政府職員を対象に、AIエージェントを使える環境「エージェントチャット」の導入が始まり、あわせてこの基準が公表されました。
適用対象は、デジタル庁が提供する源内を使う政府職員などで、大学は対象ではありません(p.4)。ただしデジタル庁は、AIエージェントの導入を検討する地方公共団体や民間事業者などにも参考になるとしています(公表ページ)。基準は、AI事業者ガイドラインなども踏まえて作られています(p.4)。
利用者である職員が守る事項のうち、エージェントの利用にかかわるものは次のとおりです。
- AIによる処理をそのまま受け入れず、業務の適切な段階で確認、判断、承認、修正、監督、停止を行う(p.22)
- 対応の例として、AIが複数の処理を続けて実行するときは重要な処理の前に利用者が確認・承認する、ファイルの更新・削除など影響の大きい処理は実行するかどうかを利用者が判断する、などを挙げている(p.22)
- 実行した処理、参照した情報、指示、ツールの利用などの履歴を必要に応じて記録し、後から検証できるようにする(p.23)
- 組織が認めていない生成AIサービス(いわゆる「シャドーAI」)を業務に使わない(p.24)
- 入力する情報や参照させる情報は、機密性、個人情報、知的財産権、利用権限を事前に確かめ、適切な範囲に限る(p.25)
- 生成された内容は、根拠資料、数値、引用、法令、宛先を利用者自身が確かめる。重要な判断や外部への発信は、必要な確認・承認を経る(p.25〜26)
管理者とシステムの側にも定めがあります。各府省庁の管理者は、利用者個人の注意だけに頼らず、組織として統制する責任を負い、利用者の教育、リスクの周知、定期的なリスク評価、事故対応の手順などを整えることとされています(p.29)。エージェントチャット自体も機能を絞った環境です。AIが上書き・削除できるのはAIが生成したファイルに限られ、利用者のPCを直接操作することや、源内の開発者が管理していないAPIなどへ直接接続することはできません(p.30、2026年10月時点)。
以下は筆者の意見です。源内基準の内容は、上で整理した権限・記録・最終確認の3点と重なります。そのうえで参考になるのは、利用者の注意だけに頼らず、管理者による統制と、システム側の機能制限を組み合わせている点です。大学が市販のエージェント製品を使う場合、こうした機能制限が最初から用意されているとは限りません。製品の設定や契約で同じような制限をかけられるかを、導入の前に確かめる必要があると考えます。
最終確認を人が行えば足りるのか
3点目の最終確認には、人が確認の工程にいるだけで足りるのか、という論点が残ります。筆者はnote「最後に人間が決めれば判断は自分のものなのか」で、最後に承認する人がいても、何を対象にし、何を比べるかという前提をAIの提案のまま受け入れていれば、判断できる範囲は狭くなると書きました。
そこで紹介したAnthropicの研究「How AI agents shape experts’ judgment calls」(2026年10月27日)では、実務家50人がAIエージェントを使って分析を行いました。分析上の選択の86%が、AIに無作為に割り当てられた推奨の方向と一致しています。推奨を意図的に強めた、単一の課題での結果である点には注意が必要です。
以下は筆者の意見です。エージェントに作業を任せると、確認する人が見るのは、まとめられた結果だけになりがちです。どの資料を集め、どれを対象から外したのかをたどれなければ、最終確認は形だけになります。3点のうちの記録は、事故の原因を調べるためだけでなく、確認する人が前提に立ち戻るためにも必要だと考えます。
現場での線引きチェックリスト
ここまでの内容を、確認項目の形にまとめます。事例とガイドラインをもとにした筆者の案で、学内の規程や契約の内容に応じた読み替えが必要です。
使い始める前に確認すること
- 学内の情報セキュリティ規程や生成AIの利用ルールで、エージェントの利用が認められているか
- 操作の対象となるサービスの利用規約が、自動化されたアクセスやエージェントの利用を禁じていないか
- AIサービスの契約条件(入力データの保存期間、学習への利用、委託先)を確認したか
- エージェントに渡すアカウントとフォルダを、その業務に必要な範囲に絞ったか
使うときに確認すること
- パスワード、APIキー、個人情報を、指示文や会話に貼り付けていないか
- 「以後確認しない」のような恒久的な許可を、内容を読まずに選んでいないか
- ログイン、送信、申請、支払、削除は、人が行うか、実行の直前に人が確認する設定になっているか
使った後に確認すること
- 出力に含まれる数値、条文、出典を原資料と照合したか
- 指示の内容と実行結果の記録が残っているか
- 確認する人が、エージェントが何を集め、何を対象から外したかをたどれるか
- 設定ファイルや履歴に認証情報が残っていないか。残っていた場合は、その認証情報を変更したか
人が行う操作とエージェントに任せる操作を分ける基準は、取り消せるかどうかで考えるとわかりやすいと思います。下書きや一覧は作り直せますが、送信したメールや提出した申請は元に戻せません。
まとめ
AIエージェントは、調査の下調べ、文書の下書き、データの加工、定型的なWeb操作の補助といった場面で、大学事務の作業時間を減らせる可能性があります。その一方で、操作まで実行するという性質から、確認すべき論点が増えます。相手先のサービスの規約、認証情報の置き場所、そして権限・記録・最終確認の3点です。委託先を含めた入力情報の行き先は、チャット型AIにも共通する論点です。最終確認は、確認する人が前提までたどれる形にしておく必要があります。
取り上げた3つの事例には、調査や当事者間の協議が続いているものもあります。導入を検討する際は、参照資料の原文で最新の状況を確認すべきかと思います。
エージェントに任せるのは作り直せる作業を中心にし、送信・申請・支払・削除のような取り消せない操作は、人が行うか、実行の直前に人が確認する。ログインも認証情報を扱うため同じ扱いにし、結果の確認は人が受け持つ。この線引きを先に決めてから、使う場面を広げていくのがよさそうです。
参照資料
- 総務省・経済産業省「AI事業者ガイドライン(第1.2版)」本編(令和8年3月31日、PDF)
- 総務省・経済産業省「AI事業者ガイドライン(第1.2版)別添(付属資料)」(令和8年3月31日、PDF)
- デジタル庁「ガバメントAI 源内においてAI エージェント利用環境の提供を開始するとともに、「源内基準」を公表します」(2026年11月6日更新)
- デジタル庁「ガバメントAI 源内 ガバナンス・セキュリティ・セーフティに関する基準(「源内基準」)」(第1版、2026年10月、PDF)
- Claude Code Docs「Overview」
- OpenAI「dots のご紹介」(2026年9月29日公表、11月3日更新)
- TechCrunch「How OpenAI turned its coding tools into dots, an always-on personal assistant」(2026年10月26日)
- GeekWire「Amazon blocks Meta’s Muse AI assistant in new standoff over agentic shopping」(2026年9月20日)
- Meta「Introducing Muse: The World’s First Personal AI Agent Built for Everyone」(2026年9月8日)
- Apiiro「Coding Agents Are Leaking Your Secrets to GitHub」(2026年11月5日公表、11月8日追記)
- Notion「Fireworks AI incident」(2026年11月9日公表、11月13日更新)
- Notion ヘルプ「What is Notion AI? FAQs」
- Anthropic「How AI agents shape experts’ judgment calls」(2026年10月27日)
- 岡野原大輔『ヒトとAI』(岩波新書)
- 筆者のnote「最後に人間が決めれば判断は自分のものなのか」(2026年11月11日)
あわせて読みたい解説
AIに判断を任せたときの責任の所在については、書評の形でまとめています。

Claude Codeを業務外で使い続けて感じたことは、こちらに書いています。

学校法人会計・大学財務の記事は、次のガイドから探せます。


